Existe uma crença muito difundida: a de que, ao desmarcar a opção "usar minhas conversas para melhorar o modelo", os seus dados desaparecem no mesmo instante em que você fecha a janela. A realidade é mais interessante — e conhecê-la é o primeiro passo para usar IA com segurança.
Toda vez que você conversa com uma ferramenta como ChatGPT, Gemini ou Claude, suas palavras entram em um percurso com várias etapas. A boa notícia é que esse percurso é previsível e pode ser desenhado. Foi exatamente isso que fizemos: um mapa do caminho que a informação percorre desde o momento em que você aperta "enviar".
O ponto de partida: o fluxo comum
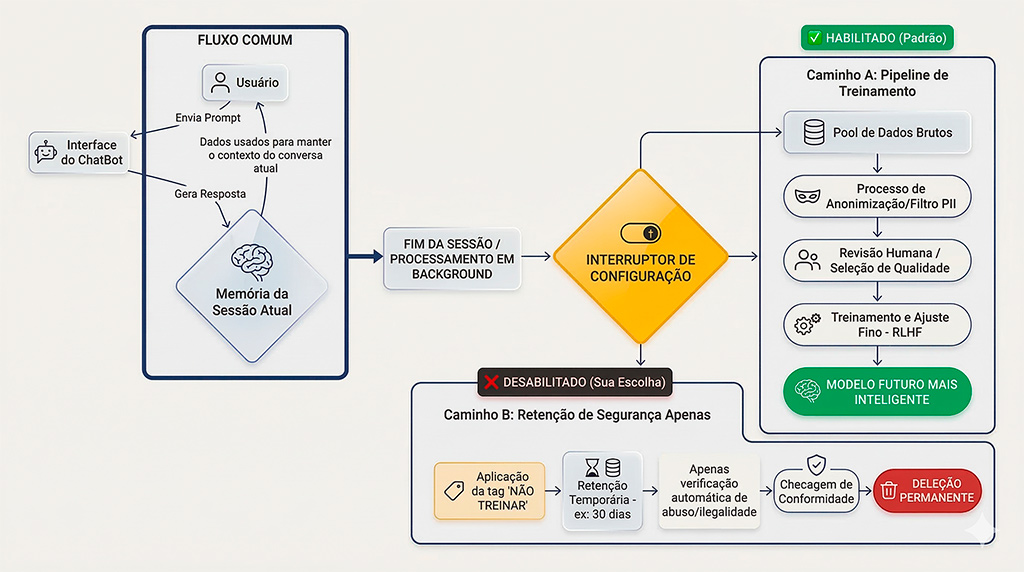
Você envia um prompt pela interface do chatbot. Esse texto vai para o "cérebro" da IA e fica guardado, por alguns instantes, na memória da sessão atual — a chamada janela de contexto. É ela que permite à IA lembrar do que você disse duas mensagens atrás e responder com coerência.
Até aqui, nada de mais: isso é apenas o funcionamento normal de uma conversa. A diferença crucial aparece no instante seguinte, quando a conversa termina e o processamento em segundo plano começa. É nesse momento que a sua escolha de privacidade entra em ação.
Ao final da sessão, os seus dados encontram o que podemos chamar de interruptor de configuração: aquele botãozinho de privacidade que você ligou ou desligou nas configurações. Ele funciona como um trilho de trem que decide para qual lado o vagão vai seguir. A partir daqui, há dois caminhos possíveis.
alt_route Os dois caminhos
Caminho A — o pipeline de treino (o padrão). Se o interruptor está ligado, e esse é o estado padrão na maioria das contas gratuitas e pessoais, suas conversas seguem para um grande reservatório de dados. Ali passam por um filtro de anonimização, que tenta esconder dados pessoais óbvios, e uma parte é enviada para revisão humana: pessoas contratadas leem trechos das conversas para avaliar a qualidade das respostas. Esse material alimenta o ajuste do modelo (o chamado RLHF) e resulta em um "modelo futuro mais inteligente" — construído, em boa medida, sobre o que os usuários digitaram.
Caminho B — retenção de segurança apenas (a sua escolha). Se você desativou o treino, os dados recebem uma etiqueta invisível de "Não Treinar". Essa marca os desvia do pipeline de aprendizado. Mas — e aqui está o ponto que quase todo mundo desconhece — eles não são apagados na hora. Passam por uma retenção temporária (frequentemente 30 dias), o chamado Safety Hold, durante a qual a empresa faz apenas verificação automática de abuso e ilegalidade. Só depois dessa checagem de conformidade é que ocorre a deleção permanente.
lightbulb A conclusão que muda tudo
Desativar o treino funciona: impede que suas conversas sejam absorvidas para dentro do modelo. O que ela não faz é apagar tudo instantaneamente. Existe uma janela silenciosa de retenção — curta, com finalidade de segurança, mas real. Entender isso não é motivo para pânico; é o que permite decisões conscientes, como as que veremos nos próximos módulos.
settings Onde desativar nas três ferramentas
Entender o fluxo é metade do caminho. A outra metade é saber onde clicar. Veja a tela de configuração de privacidade em cada ferramenta — toque em uma imagem para ampliar. As telas mudam de tempos em tempos, mas o caminho costuma estar em Configurações → Dados / Privacidade.
As telas e os nomes exatos das opções podem mudar conforme a plataforma atualiza suas configurações.
Especialistas em privacidade têm um nome para o que acontece no Caminho A: uso secundário. É quando um dado coletado para um fim (fazer a IA responder à sua pergunta) passa a ser usado para outro (treinar o modelo). Não é um risco exclusivo da IA — mas a escala em que a IA faz isso, com bilhões de conversas, é o que o torna algo novo. Guarde esse termo: ele reaparece em quase todo debate sério sobre dados.
Conceito apresentado no curso AI Security (Infosec, via Coursera).
O fluxo dos seus dados, termo a termo
Toque em cada termo abaixo para revelar a definição, uma analogia do cotidiano e um prompt pronto para você praticar com uma IA.